00이 노트로 공부하는 것
걸어 다니는 휴머노이드 G1이 정비 작업지시서 한 장을 받아 부품창고 랙에서 박스를 모으고 출고하기까지를 시뮬레이션으로 만든 과정을 정리한 노트다. 처음 쓰는 가상 지시서 200장으로 끝까지 돌려 30차에서 89장(배치를 바꾼 다시 잼 94장)을 완수했고, 목표(60 %, 120장)에는 못 미친다. 앞서 28차의 120장은 AMR이 로봇을 통과하던 판의 값이다(12절). 200장 중 60장은 멈춰야 맞는 이상 지시라 최대는 140장이다.
01~07절은 기초 개념이다: 물리 시뮬레이션과 접촉, 로봇 몸과 역기구학, 강화학습과 공개 보행 정책, 쥐기와 마찰, 카메라와 깊이, 언어모델과 규칙 검사, 시험 결과를 읽는 법. 개념마다 이 프로젝트에서 어떻게 썼는지를 같이 적었다. 08절부터는 프로젝트의 단계별 기록이고, 15~17절은 한계, 용어, 참고 자료다.
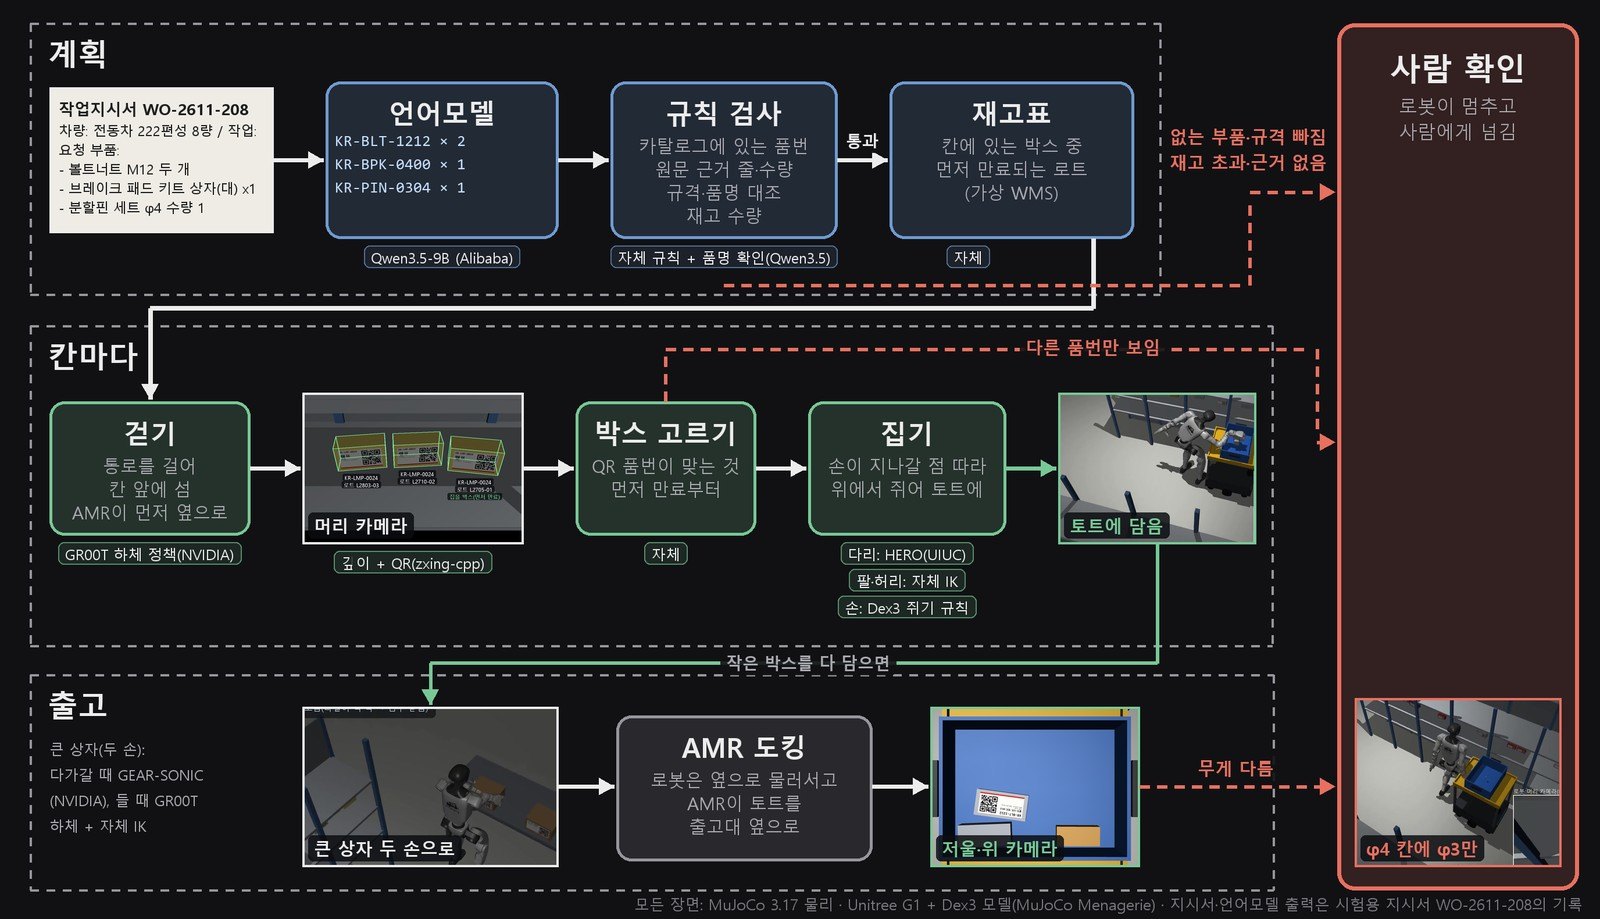
전체 흐름과 단계마다 쓴 소스
| 단계 | 하는 일 | 쓴 소스 | 맡은 역할 |
|---|---|---|---|
| 지시서 읽기 | 글로 된 지시서 → 품번·수량 목록 | Qwen3.5-9B(Alibaba, Apache-2.0), A6000 PC | 지시서 해석, 글자 대조가 못 맞춘 품명을 같은 부품인지 다시 확인 |
| 규칙 검사·재고표 | 카탈로그·재고·근거 줄·수량·규격·품명 대조, 먼저 만료 로트 | 자체(sim/work_order.py) | 언어모델이 틀려도 잘못 출고하지 않게 막는 문 |
| 걷기·서기 | 통로를 걸어 칸 앞에 섬 | GR00T 하체 정책(NVIDIA, Balance·Walk ONNX) | 다리 12관절. 위에서 걷기 명령만 줌 |
| 보고 고르기 | 머리 카메라로 박스 위치·방향, QR 품번 | MuJoCo 렌더(컬러 + 깊이), zxing-cpp, 박스 추정은 자체 | 로봇이 아는 것만으로 박스를 고름(시뮬 참값을 쓰지 않음) |
| 집기 | 위에서 쥐어 AMR 위 토트에 | 팔·허리: 자체 IK, 다리: HERO(UIUC, MIT), 손: 자체 쥐기 규칙 | 손이 박스를 쥘 때까지 HERO가 몸이 밀리지 않게 다리를 씀 |
| 큰 상자 | 두 손으로 들어 출고대 옆 받침에 | GEAR-SONIC v1.1(NVIDIA)로 다가가고, 들 때는 GR00T 하체 + 자체 IK | 한 손으로 못 쥐는 폭의 상자 |
| 출고·확인 | AMR이 토트를 도킹 자리로, 저울로 확인 | 자체(AMR 경로, 저울은 가정값) | 무게가 다르면 사람 확인 |
| 밑바탕 | 물리, 로봇 모델 | MuJoCo 3.17, Unitree G1 + Dex3(MuJoCo Menagerie) | 모든 장면 |
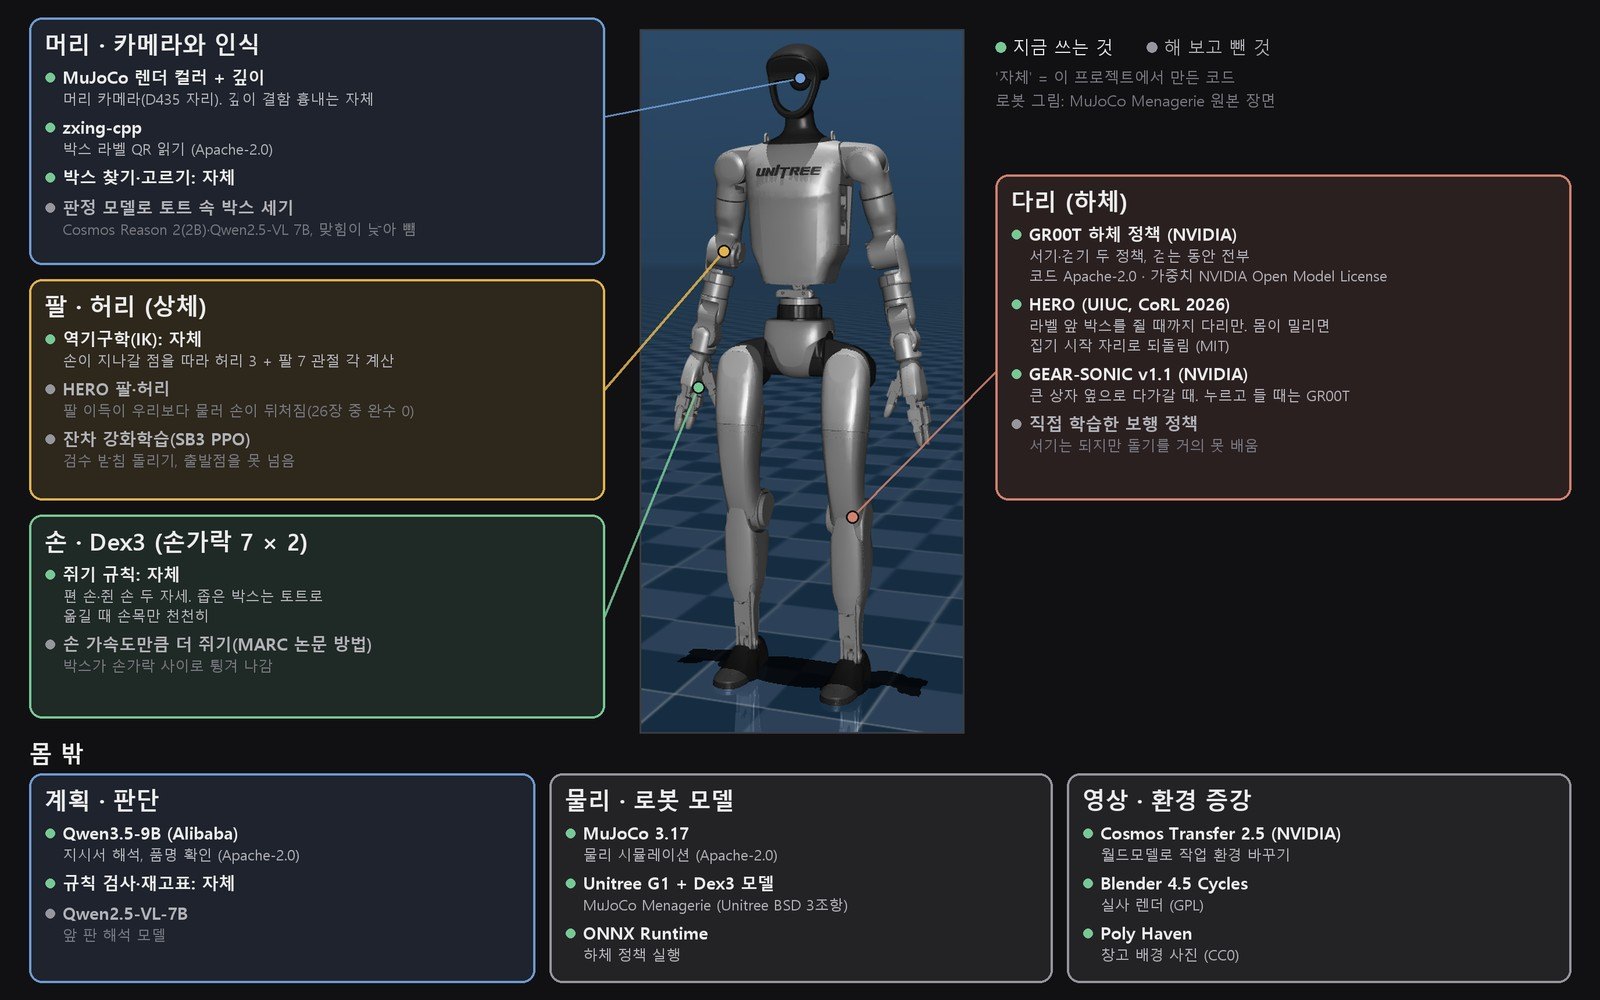
몸 부위별 오픈소스
읽는 법
절 제목을 누르면 펼쳐진다. 머리의 목차 단추로 어디든 건너뛴다. 숫자는 모두 시뮬레이션 기록 파일에서 옮긴 값이고, 품번·치수·무게는 가상값이다. 실패한 시도와 버그도 함께 적었다.
2_휴머노이드_부품출고에 있다. 진행 기록은 PROGRESS.md, 계획은 PLAN.md.01기초: 물리 시뮬레이션과 접촉
물리 시뮬레이터는 짧은 시간 간격마다 힘을 계산해 물체의 위치와 속도를 다음 순간으로 옮긴다. 로봇을 실제로 만들기 전에 동작을 시험할 수 있지만, 모델에 넣지 않은 것은 결과에 나타나지 않는다.
시간 간격과 제어 주기timestep, control rate
시뮬레이터는 운동 방정식을 시간 간격 하나씩 풀어 나간다. 간격이 짧을수록 정확하지만 오래 걸린다. 제어기는 보통 그보다 느린 주기로 명령을 낸다.
sim/params.json, sim/manip.py.접촉과 부드러운 눌림soft contact
두 물체가 닿으면 시뮬레이터가 서로 밀어내는 힘을 계산한다. MuJoCo의 접촉은 조금 파고드는 것을 허용하는 방식이라, 닿아 있는 물체 사이에 작은 겹침이 항상 생긴다.
충돌 비트collision filtering, contype, conaffinity
모든 물체 쌍을 검사하면 느리고, 일부러 안 부딪히게 할 물체도 있다. MuJoCo에서는 물체마다 숫자 비트 두 개를 주고, 두 물체의 비트가 겹칠 때만 부딪힘을 계산한다.
sim/scene.py). 처음에는 AMR 충돌을 꺼 뒀는데, 그래서 AMR이 로봇을 지나가도 시뮬레이션이 아무 신호도 내지 않았다(12절).움직임을 정해 둔 물체mocap body, kinematic object
힘으로 움직이지 않고 코드가 위치를 직접 정하는 물체다. 어떤 힘을 받아도 밀리지 않으며, 부딪힌 상대만 밀려난다.
02기초: 로봇 몸과 역기구학
휴머노이드는 관절 수십 개를 동시에 움직인다. 손을 어디로 보낼지 정하면, 그 자리에 맞는 관절 각도를 계산하는 일이 역기구학이다.
자유도DoF, degrees of freedom
로봇이 독립적으로 움직일 수 있는 방향의 수다. 회전 관절 하나가 자유도 하나다. 몸 전체가 공간에서 움직이고 도는 6자유도가 따로 더해진다.
순기구학과 역기구학forward kinematics, inverse kinematics
순기구학은 관절 각도에서 손 위치를 계산한다. 한 가지 답이 바로 나온다. 역기구학은 손 위치에서 관절 각도를 찾는다. 답이 여럿이거나 없을 수 있어 반복 계산으로 푼다.
sim/kin.py는 감쇠 최소제곱을 반복한다. 허리 3 + 오른팔 7관절을 풀고, 허리는 팔보다 덜 쓰도록 가중치를 낮췄다. 오른손목이 돌 수 있는 범위는 약 150°다. 그만큼 돌린 손으로는 칸 안쪽에 8~24 cm 못 닿아, 칸 안에서 박스를 돌려 다시 놓는 방식을 버렸다.야코비안과 감쇠 최소제곱Jacobian, damped least squares
야코비안은 관절이 조금 움직일 때 손이 얼마나 움직이는지를 담은 행렬이다. 손 오차에 이 행렬의 역을 곱하면 고칠 관절량이 나온다. 팔이 다 펴진 자세에서는 역행렬 값이 커져 관절이 튀는데, 작은 값을 더해 누그러뜨리는 것이 감쇠다(Wampler 1986).
위치 제어와 이득PD control, gain
모터에 목표 각도를 주면 지금 각도와의 차이에 이득 kp를 곱한 힘을 낸다. 이득이 크면 손이 정확하게 따라오지만 부딪혔을 때 세게 민다. 이득이 작으면 부드럽지만 뒤처진다.
손 동작 나누기waypoints
집기를 한 번의 계산으로 풀지 않고, 앞에서 멈추기·들어가기·내려가기·쥐기·들기·빼기·토트 위·내리기·놓기처럼 짧은 구간으로 나눠 구간마다 목표를 준다.
sim/manip.py의 Pick. 빠른 구간은 초속 0.30 m, 박스를 들고 빼는 구간은 0.10 m. 몸이 흔들려 손이 늦으면 다음 구간으로 안 넘어가고 최대 3초 기다린다.03기초: 강화학습과 공개 보행 정책
두 다리로 서서 걷는 동작을 사람이 수식으로 짜기는 어렵다. 그래서 시뮬레이션에서 시행착오로 학습한 신경망, 곧 정책을 쓴다. 이 프로젝트는 직접 학습에 실패한 뒤 공개된 정책을 받아 썼다.
강화학습reinforcement learning
정책이 상태를 보고 행동을 내면, 환경이 다음 상태와 보상을 돌려준다. 정책은 보상 합이 커지는 쪽으로 조금씩 바뀐다. 사람이 정답 행동을 알려 주지 않고 점수만 준다.
PPOProximal Policy Optimization
널리 쓰는 강화학습 알고리즘이다(Schulman 외 2017). 정책을 한 번에 크게 바꾸면 성능이 무너지므로, 바뀌는 폭을 제한하며 여러 번 고친다.
잔차 강화학습residual reinforcement learning
규칙으로 짠 동작을 그대로 두고, 그 위에 더할 작은 수정만 학습한다(Johannink 외 2019). 처음부터 학습하는 것보다 시작점이 좋다.
도메인 무작위화와 시뮬-실제 차이domain randomization, sim-to-real
시뮬레이션과 실제는 마찰, 무게, 지연이 다르다. 학습할 때 이런 값을 넓게 흔들어 두면, 실제가 그 범위 안 어딘가이기를 기대할 수 있다(Tobin 외 2017).
이번에 받아 쓴 정책 세 가지GR00T, HERO, GEAR-SONIC
셋 다 G1용으로 학습되어 공개된 정책이다. 다른 로봇용 정책은 관절 수와 무게가 달라 그대로 쓸 수 없다.
sim/gr00t_loco.py).HERO: 손이 박스를 쥘 때까지 다리만. 뻗는 동안 몸이 밀리는 것을 줄였다(두 배치 합 133 → 141).
GEAR-SONIC v1.1: 큰 상자에 다가갈 때만. 다리까지 맡겨 들면 밀리거나 넘어져, 들 때는 GR00T로 바꾼다.
04기초: 쥐기와 마찰
손으로 박스를 들면 박스는 손가락 마찰로만 버틴다. 박스가 손에서 빠지는 일이 지금 못 끝낸 지시의 첫째 원인이라, 이 절의 내용이 바로 다음 과제와 이어진다.
마찰 원뿔friction cone
면을 누르는 힘이 N이고 마찰 계수가 μ이면, 미끄러지지 않고 버틸 수 있는 옆 힘은 μN까지다. 들어 올린 박스의 무게와 흔들릴 때의 가속도까지 합친 힘이 이를 넘으면 박스가 빠진다.
sim/scene.py의 가정값이다.위치 모터로 쥐기position-controlled grasp
위치 모터로 쥐면 쥐는 힘을 직접 주지 못한다. 손가락 목표와 실제 각도의 차이에 이득을 곱한 힘이 쥐는 힘이 된다. 그래서 목표를 더 넘겨 쥐면 힘은 커지지만 접촉이 튀기 쉽다.
좁은 박스narrow objects
Dex3 손은 한 손에 약 6.2 cm 폭까지 쥔다. 손가락 사이에 잘 들어오지 않는 좁은 박스는 닿는 면이 작아 조금만 틀어져도 빠진다.
몸이 흔들리면 손도 흔들린다whole-body coupling
서 있는 로봇이 팔을 멀리 뻗으면 무게 중심이 옮겨 가고, 보행 정책이 균형을 잡으려 다리를 움직인다. 그 움직임이 손으로 전해진다.
05기초: 카메라와 깊이
카메라 영상의 화소 하나는 공간의 한 방향에 해당한다. 그 방향으로 얼마나 떨어졌는지를 알려 주는 것이 깊이이고, 둘을 합치면 3차원 점이 나온다.
핀홀 카메라 모델pinhole camera
물체가 작은 구멍 하나를 지나 영상에 맺힌다고 보는 모델이다. 초점 거리를 화소 단위로 쓰면, 화소 위치와 깊이에서 3차원 좌표를 바로 계산한다.
sim/box_est.py가 깊이 영상을 세계 좌표 점으로 바꾼다. 카메라 자세는 머리에 고정된 값과 로봇 몸의 자세로 정한다. 장착 오차는 시험 때 일부러 넣는다.능동 스테레오 깊이active stereo depth
나란한 두 카메라가 같은 점을 볼 때 생기는 위치 차이(시차)로 거리를 계산한다. 먼 곳일수록 시차가 작아 오차가 거리의 제곱으로 커진다.
시뮬레이션 그림 설정near clipping plane
렌더러는 카메라 바로 앞 일정 거리 안쪽을 그리지 않는다. 이 값이 크면 가까운 물체가 잘려 보이고, 그 뒤의 물체가 비쳐 보인다.
QR로 품번 읽기QR code
바코드와 달리 가로·세로로 정보를 담고 오류 정정이 있어 일부가 가려져도 읽힌다. 다만 카메라를 충분히 정면으로 보고 해상도가 맞아야 한다.
06기초: 언어모델과 규칙 검사
언어모델은 글을 읽고 다음 글자를 차례로 만들어 낸다. 사람이 쓴 지시서를 표 형식으로 바꾸는 데 쓸모가 있지만, 모르는 것도 그럴듯하게 채운다. 그래서 그 결과를 코드로 검사한다.
언어모델과 추론LLM, inference
학습이 끝난 모델은 이미 있는 가중치로 답을 낸다. 이것이 추론이다. 답을 만드는 데 드는 시간과 메모리는 모델 크기에 달려 있다.
out/plan/pred_q35_test.json) 로봇 시뮬레이션이 읽는다.구조화된 출력structured output
글로 답하게 하지 않고 정해진 항목을 JSON으로 내게 한다. 코드가 바로 읽어 검사할 수 있다.
sim/work_order.py).환각hallucination
모델이 없는 사실을 있는 것처럼 답하는 현상이다. 모델 자신은 틀렸다고 알리지 않는다.
막는 문을 코드로 두기guardrail
모델이 내놓는 결과가 틀렸을 때의 피해가 크면, 모델을 믿는 대신 판정이 분명한 코드로 결과를 거른다. 대신 멀쩡한 답이 막히기도 한다.
07기초: 시험 결과를 읽는 법
같은 시스템도 시험 방법에 따라 숫자가 크게 달라진다. 이 절은 이 프로젝트에서 숫자를 믿거나 버린 기준을 모은 것이다.
처음 쓰는 시험 세트held-out test set
개발 때 본 자료로 시험하면 그 자료에 맞춘 만큼 점수가 부풀려진다. 개발에 쓰지 않은 자료를 따로 둔다.
표본 흔들림sampling noise
200번 중 89번 성공했을 때 그 비율의 표준오차는 약 3.5 %포인트다. 95 % 구간으로 쓰면 약 ±14장이다.
부분 묶음의 함정selection bias, regression to the mean
실패한 판만 모아 다시 돌리면, 운이 나빴던 판이 섞여 있어 아무것도 안 고쳐도 좋아진다. 처치가 효과 있어 보이는 것이다.
못 재는 것은 안 보인다proxy metric
지표는 재고 싶은 것 일부만 담는다. 지표가 오른다고 시스템이 그만큼 좋아졌다고 말할 수 없다.
좋은 장면 고르기cherry-picking
성공한 영상만 보여 주면 성공률을 알 수 없다. 영상을 어떻게 골랐는지를 같이 적는다.
08걷는 로봇과 창고
다리는 공개된 강화학습 보행 정책에 맡기고, 허리와 팔은 역기구학으로 따로 움직인다. 손 달린 G1으로 보행 정책을 직접 학습했을 때는 서기는 됐지만 제자리 돌기를 거의 배우지 못해 공개 정책으로 바꿨다.
하체 보행 정책locomotion policy
관절 각도·속도, 몸의 기울기, 원하는 걷기 속도(앞뒤·옆·회전)를 받아 다리 관절 목표를 내는 신경망이다. 시뮬레이션에서 강화학습으로 학습해 두면, 위에서는 속도 명령만 주면 된다.
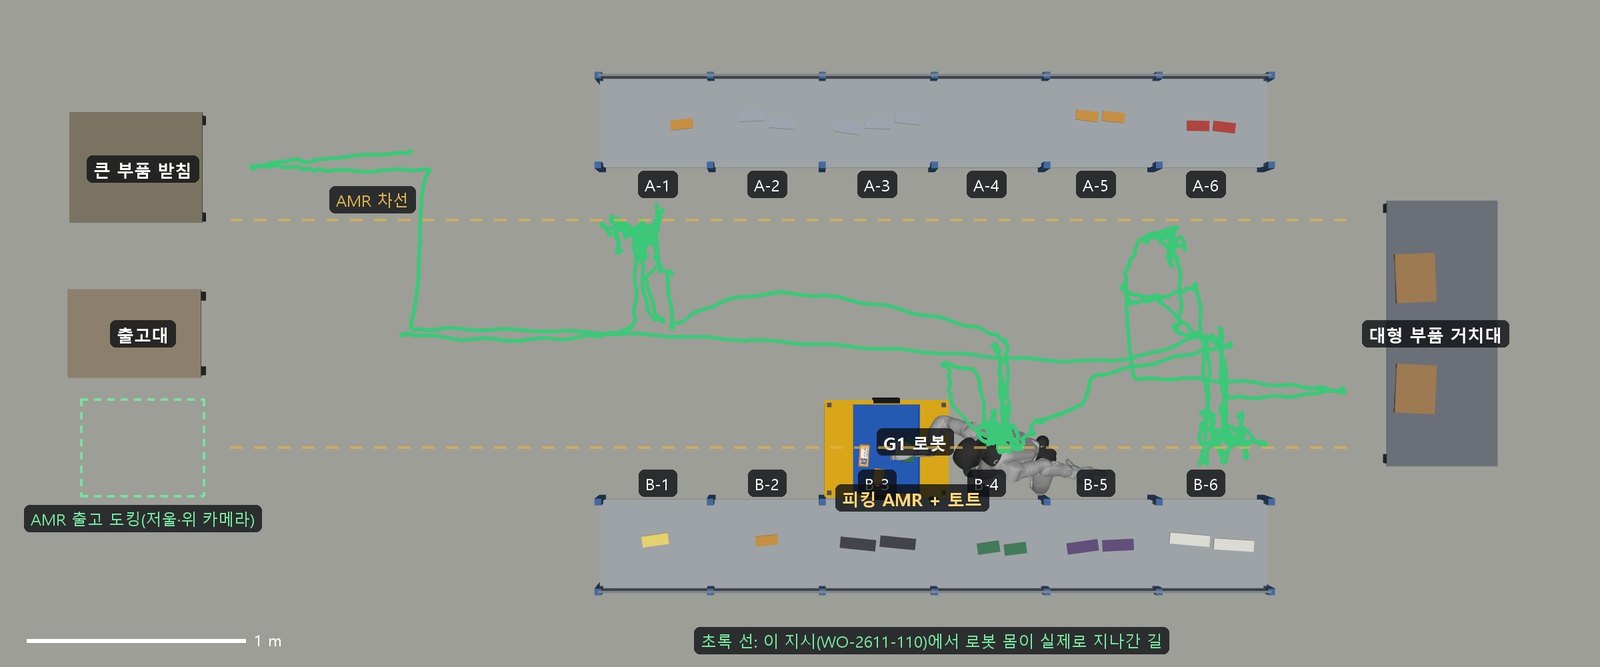
피킹 AMRAutonomous Mobile Robot
창고에서 사람이나 로봇 옆으로 와서 기다리는 바퀴 달린 카트. 로봇이 칸 앞에 서면 옆 차선으로 와 서고, 로봇은 그 위 토트에 박스를 담는다.
큰 상자 두 손 들기bimanual lifting
한 손 폭(약 6.2 cm)을 넘는 상자는 두 손으로 양옆을 눌러 마찰로 든다.
09머리 카메라로 박스 찾기
G1 머리에는 깊이 카메라 D435 하나가 몸통에 고정되어 있고 고개가 없다. 손이 박스 앞으로 오면 손이 박스를 가리므로, 손을 뻗기 전에 허리를 숙여 칸을 한 번 보고 그 추정을 기억한 채 뻗는다.
먼저 보고 뻗기look-then-reach, open-loop grasping
깊이 영상 한 장으로 잡을 곳을 정하고, 뻗는 동안에는 다시 보지 않는 방식이다. 물체가 가만히 있으면 손목 카메라로 계속 고치는 방식과 성공률이 비슷하다는 결과가 있다(Morrison 외 2018). 깊이 한 장으로 잡을 곳을 정한 Dex-Net 2.0(Mahler 외 2017)도 같은 계열이다.
sim/box_est.py: 깊이 → 세계 좌표 점 → 칸 안·선반 위 점만 → 4 mm 격자 덩어리 → 윗면 최소 면적 사각형으로 박스 중심·방향, 품번 치수와 안 맞는 덩어리는 버림. 정지 시험 박스 107개를 모두 찾았고 위치 오차는 최대 0.50 cm.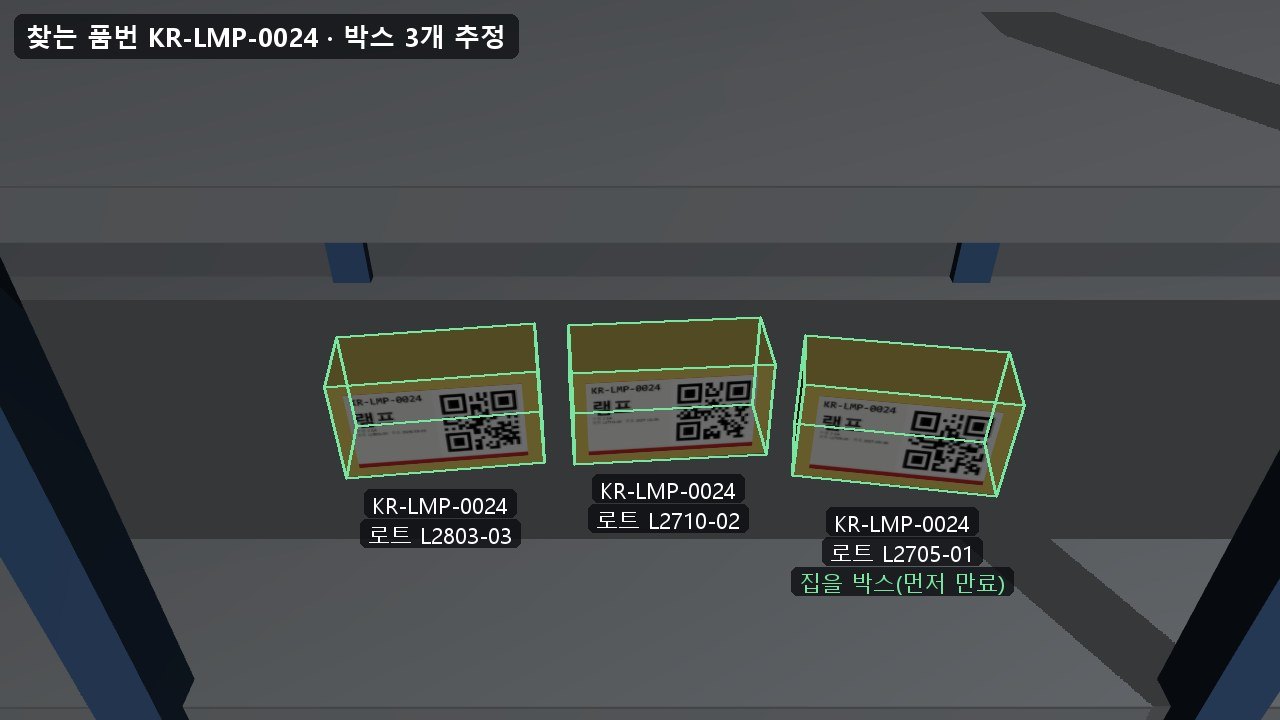
깊이 카메라 결함stereo depth artifacts
능동 스테레오 깊이 카메라는 거리의 제곱에 비례하는 잡음, 앞 물체 왼쪽의 가림 그림자, 물체 가장자리의 구멍과 튀는 점을 낸다. 시뮬레이션 깊이는 이런 결함이 없어 너무 깨끗하다.
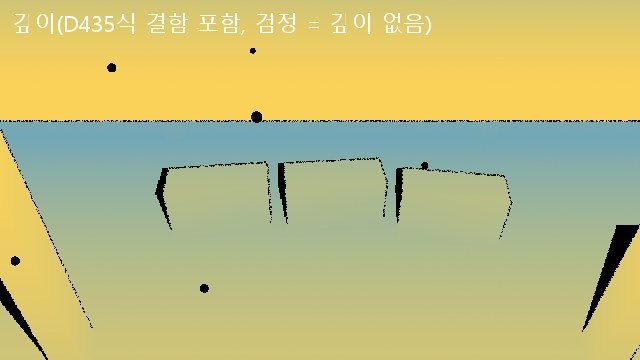
그림 절단 거리 버그
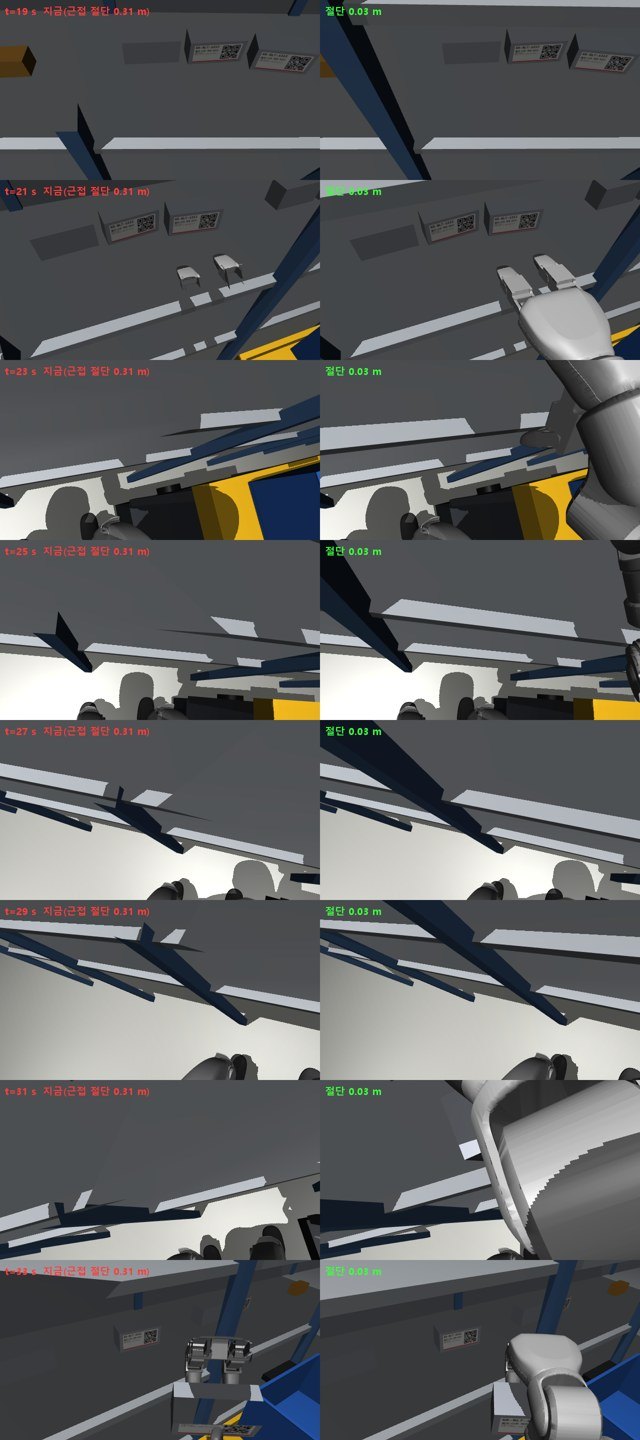
머리 카메라 화면에서 박스를 집을 때 손이 사라진다는 지적을 받고 원인을 찾았다. MuJoCo는 카메라 바로 앞 일정 거리 안을 그리지 않는데, 그 거리가 장면 크기(31 m)에 비례해 0.31 m였다. 손·팔·가까운 선반 판이 잘려 보였다. 2 cm로 고치자 위 선반 판이 키 큰 공기필터 박스(9 cm) 윗면을 가려 그 박스를 못 보는 일이 드러났다. 그전까지는 판이 잘려 판 너머가 보였던 것이고, 지시 완수는 41장에서 35장으로 내려갔다. 볼 때만 반 걸음(0.15 m) 물러서게 해 39장으로 올렸다.
10라벨이 벽 쪽인 박스(25차부터 뺌)
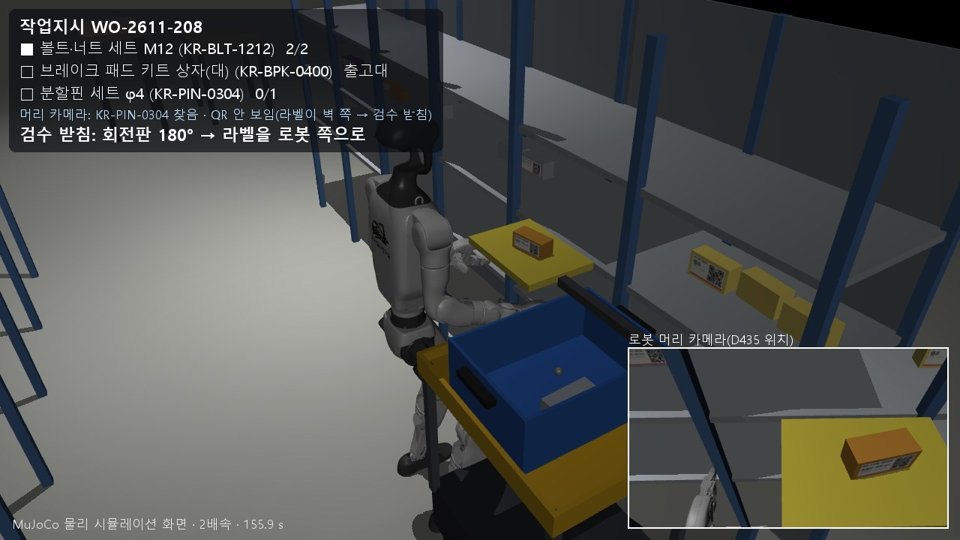
박스 라벨은 긴 옆면 한쪽에만 있고, 랙에 거꾸로 꽂힌 박스는 라벨이 벽을 본다. 로봇은 그 박스를 받침에 놓고 받침이 180° 돌아 라벨이 로봇 쪽으로 오면 머리 카메라로 QR을 읽은 뒤 담는다. 이 장치에 이르기까지 네 가지를 시도했다.
| 시도 | 결과 |
|---|---|
| 들고 손에서 돌려 보여 주기 | 손가락이 쥐는 면이 라벨 면이라(박스 좁은 쪽만 쥘 수 있음) 어떻게 돌려도 라벨이 가려짐 |
| 선반 위에서 박스 돌리기(규칙 2가지, 강화학습 3번) | 성공률이 낮아 접음(강화학습 800만 스텝 뒤 2 %) |
| 받침에 놓고 두 손 번갈아 90°씩 두 번 | 두 번 돌리는 사이 박스가 받침 밖으로 나감. 끝에서 끝 86개 중 5개만 토트까지 |
| 회전 검수대(받침 윗판이 관절과 모터로 180°) | 지금 방식. 84개 중 19개 → 개선을 거쳐 70개 중 39개 |
위치로만 움직이는 물체와 마찰mocap body
MuJoCo의 mocap 물체는 위치를 매 순간 옮겨 놓는 물체라 속도가 없다. 그래서 그 위에 놓인 물체를 마찰로 끌고 가지 못한다.
그 뒤 고친 것: 읽은 박스를 토트로 옮길 때 손에서 빠져서 천천히 옮기게 함(읽은 7개 중 토트 1 → 7), 라벨이 비스듬해 못 읽으면 판을 ±35°·±70° 더 돌려 다시 읽음(다시 읽어 살린 박스 14개), 품번을 끝내 못 읽으면 토트에 넣지 않고 사람 확인. 효과가 없거나 나빠진 것: 손가락 더 쥐기, 받침 턱, 받침을 0.98·1.05 m로 올리기, 읽은 자리에서 바로 집기.
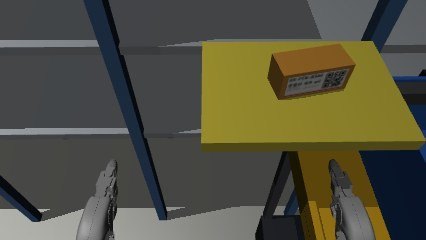
놓는 자리와 다시 집는 손(12차)
받침에 놓기가 끝에서 끝 실패의 첫째 원인이었다. 놓는 순간 손이 어디서 멈추는지 몸 기준으로 재 보니, 실패한 판은 손이 목표보다 앞으로 7~12 cm, 오른쪽으로 4~8 cm, 위로 6~10 cm에 있었다. 박스를 180° 돌려 든 팔로는 몸 앞 15 cm까지 손을 끌어오지 못한다는 뜻이다. 받침을 오른쪽으로 5 cm, 놓는 점을 앞으로 8 cm 옮기자 손 오차가 1.3 cm로 줄었다. 그런데 이번에는 다시 집으려고 팔을 올리는 순간 박스가 받침에서 떨어졌다. 걷는 자세로 내린 오른손이 옮긴 받침 바로 아래에 있어, 위로든 박스 쪽으로든 움직이면 받침을 쳤다. 손을 옆으로 22 cm 먼저 뺀 뒤 올리니 검수 박스가 토트까지 간 비율이 56 %에서 77 %로, 지시 완수가 39에서 47로 올랐다.
11작업지시서를 피킹 목록으로
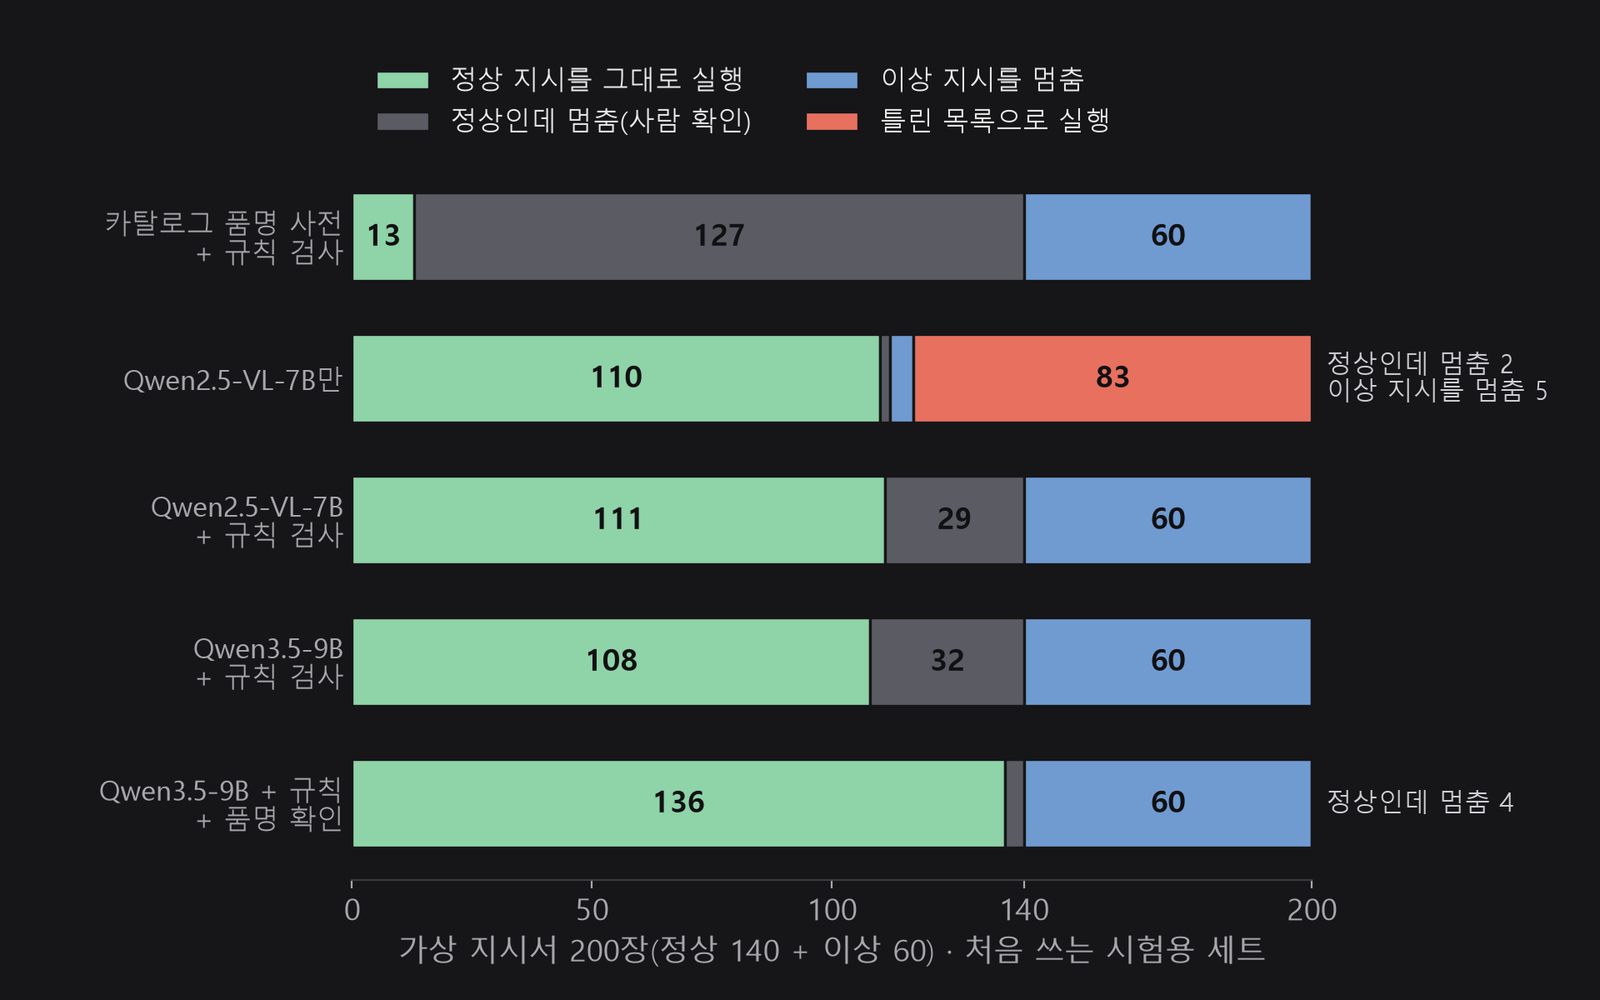
지시서 글을 언어모델이 품번·수량 목록으로 바꾸고, 규칙 검사가 통과시킨 것만 로봇이 실행한다. 언어모델만 쓰면 처음 쓰는 200장 중 83장을 틀린 목록으로 실행했고, 규칙 검사를 붙이자 2장, 품명 대조를 고친 뒤(13차) 1장, 규칙 보정을 더한 뒤(14차) 0장이 됐다.
언어모델 + 규칙 검사LLM with rule-based verification
언어모델은 표기가 제각각인 글(띄어쓰기, 약칭, φ·Ø·파이·mm, M-12)을 잘 읽지만, 카탈로그에 없는 부품이나 규격이 빠진 줄도 그럴듯한 품번으로 채운다. 규칙 검사는 그 출력을 원문과 대조해 이상하면 멈춘다.
sim/work_order.py.개발 세트와 시험 세트
규칙을 고칠 때 본 200장(개발 세트)과 최종 수치를 내는 200장(시험 세트)을 나눴다. 개발 세트에서 규격을 찾을 때 띄어쓰기를 지워 'φ3 1개'가 'φ31개'로 붙는 버그를 찾았고, 이름이 비슷한 부품(어스 브러시를 램프로)을 못 거르는 것을 보고 품명 대조를 넣었다. 품명 대조의 엄격도는 넷 중 오출고가 1 % 안인 것을 개발 세트에서 고른 뒤 시험 세트에 한 번 적용했다.
먼저 만료, 먼저 출고FEFO, First Expired First Out
같은 품번이 여러 로트로 있으면 유효기간이 먼저 끝나는 것부터 내보내는 창고 규칙.
비슷한 부품 걸러내기look-alike parts
분할핀 φ3/φ4, 볼트 M12/M16은 상자 크기가 같아 모양으로는 가릴 수 없다. 정비 현장에서 가장 위험한 실수가 잘못된 부품 출고다.
품명 대조를 음절 묶음으로(13차)
끝에서 끝 평가에서 정상 지시 140장 중 43장이 로봇에 가지도 못하고 멈췄다. 가장 많은 이유는 품명 대조였다. 낱말 단위로 겹침을 세니 '오링 키트'와 'O링 세트'는 겹치는 낱말이 없고, '접지브러시'는 붙여 써서 '접지 브러시'와 다른 낱말이 됐다. 띄어쓰기를 지우고 영문 O를 '오'로 읽은 뒤 음절 두 개씩 묶어 겹침을 세도록 바꿨다. 기준은 개발 세트만 보고 정했고(정상 그대로 실행 86 → 97, 잘못 실행 1 → 1), 시험 세트에는 정한 뒤 한 번만 돌렸다(96 → 109, 2 → 1). 비슷한 이름 부품을 바꿔 고른 경우('어스 브러시'를 O링으로)는 여전히 멈춘다.
규칙 보정(14차)
규칙 보정rule-based repair
언어모델 출력 중 믿기 어려운 줄만 골라, 원문 그 한 줄을 규칙으로 다시 읽어 고치는 것.
개발 세트에서 정상 지시를 그대로 실행한 수는 93에서 114로, 잘못 실행은 0으로 유지됐다. 시험 세트에는 정한 뒤 한 번 돌려 96에서 111, 잘못 0, 이상 지시 60장 모두 멈춤이었다. 끝에서 끝 14차에서 로봇까지 간 지시는 111장, 지시 완수 54장, 잘못 출고 0장이다.
Qwen3.5로 바꾸고 품명 확인(22차)
해석 모델을 Qwen2.5-VL-7B에서 Qwen3.5-9B(2026년 2월 공개, Apache-2.0)로 바꿨다. 같은 프롬프트, 생각 모드는 끔. 규칙 검사 없이는 정상 지시 140장 중 120장을 맞혀 앞 모델(102장)보다 나았지만, 규칙 검사를 거치면 114장으로 같았다. 멈춘 이유 대부분은 '코터핀'처럼 카탈로그 품명과 다른 말을 쓴 줄이었다. 언어모델이 그 줄을 모른다고 빼거나, 맞게 풀어도 글자 대조가 겹침 0이라 규칙이 멈췄다.
품명 확인name verification
규칙의 글자 대조가 못 맞춘 줄만 골라, 같은 언어모델에게 "이 줄의 부품이 이 카탈로그 품목과 같은 종류인가"를 품목마다 '같음/다름'으로 묻는 것.
12끝에서 끝 평가
지시서 한 장을 언어모델 해석부터 로봇 출고까지 한 번에 돌린다. 지표와 합격 목표는 결과를 보기 전에 정했다: 지시 완수율 60 % 이상, 오출고 1 % 이하, 넘어짐 5 % 이하. 지금 값은 30차로, 완수 89/200(배치를 바꾼 다시 잼 94/200)이라 완수 목표에는 못 미친다. 오출고 0장과 넘어짐 2·4/136(최대 2.9 %)은 목표 안이다. 28차에서 120/200으로 목표에 닿았지만, 그때는 AMR이 로봇을 통과하고 있었다. 25차부터는 라벨이 벽 쪽인 박스가 없다고 가정한 조건이다.
지시 완수order completion
지시서의 정답 품목과 수량이 모두 토트(큰 상자는 출고대 받침)에 있고, 잘못된 품번이 없고, 넘어지지 않은 지시.
sim/e2e_eval.py, 5090 PC에서 12개 동시로 약 35분.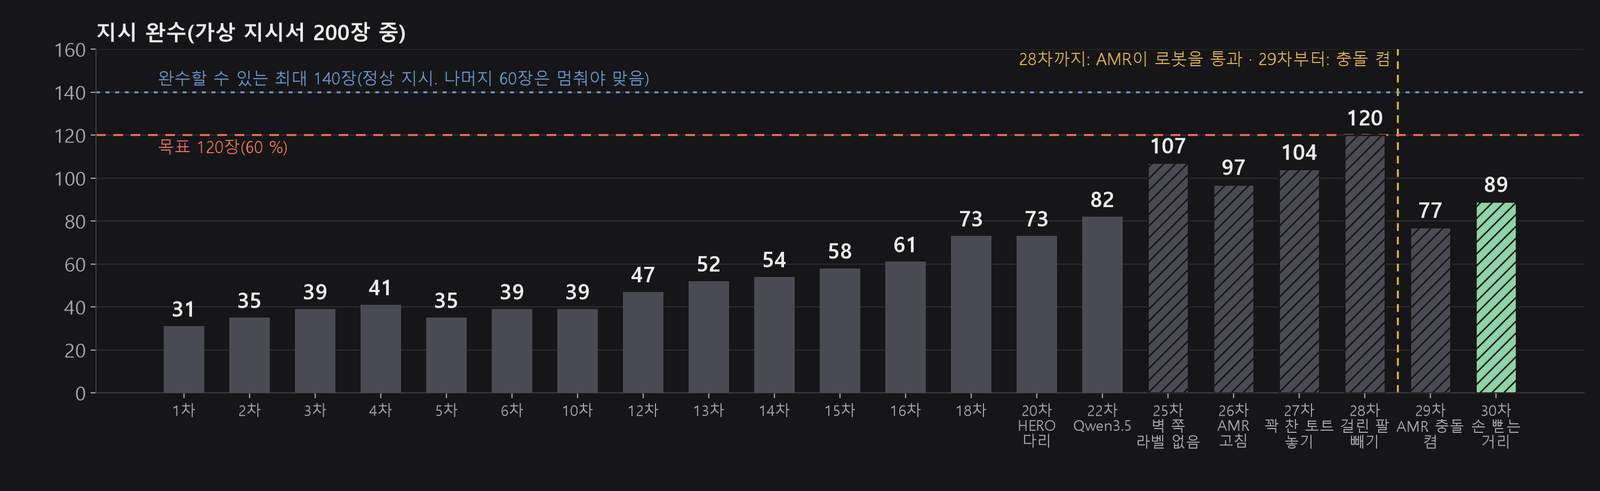
20차부터 바뀐 것
| 차수 | 바꾼 것 | 완수(두 배치) |
|---|---|---|
| 18차 | 좁은 박스는 토트로 옮길 때 손목만 천천히 | 73 · 60 |
| 20차 | 라벨 앞 박스를 쥘 때까지 다리를 HERO로(팔·허리는 IK 그대로) | 73 · 68, 넘어짐 10 → 4 |
| 22차 | 해석을 Qwen3.5-9B로 + 품명 확인 + 수량 보정(로봇까지 가는 지시 111 → 136) | 82 · 81 |
| 25차 | 라벨이 벽 쪽인 박스 없음(시나리오 변경) | 107 · 95 |
| 26차 | AMR 순간 이동 버그 고침(토트에서 빠진 박스 23 → 1). 토트가 안 비니 놓기 실패가 늘어 합은 줄어듦 | 97 · 99 |
| 27차 | 꽉 찬 토트에서 손이 막힌 높이에 놓기(놓기 실패 21 → 6), 걷기 제한 70초 | 104 · 102 |
| 28차 | 걷기 전·막혔을 때 토트 속 박스에 걸린 팔 빼기(못 본 박스 32 → 8) | 120 · 120 |
| 29차 | AMR·토트와 로봇의 충돌 켬, 안전 정지·범퍼, 차선·서는 자리 바꿈 | 77 · 69 |
| 30차 | 손 뻗는 거리를 28차와 같게(서는 거리 0.58 m + 놓는 자리 로봇 쪽 5 cm) | 89 · 94 |
그 사이 해 보고 뺀 것: 손 가속도만큼 더 쥐기(MARC 논문 방법), HERO에 팔·허리까지 맡기기, 검수 받침 일에도 HERO(21차, 효과 없음), 가까운 칸은 옆걸음만(24차, 163 → 150). 실패를 골라 담은 부분 묶음에서는 셋 다 좋아 보였는데 200장 두 배치에서는 아니었다. 그래서 채택은 200장 두 배치로만 정한다.
숫자를 크게 올린 것은 버그 찾기였다(26~28차)
못 끝낸 지시를 박스 단위로 다시 세자 두 가지가 드러났다. 박스를 담았다고 기록됐는데 끝에 사라진 지시가 있어 0.1초 기록을 넣으니, AMR이 경로를 바꿀 때 1 m를 순간 이동해 토트 속 박스가 초속 74 m로 튀어나가고 있었다. 또 걷기 시간 초과를 0.5초 기록으로 보니 회전 명령에도 몸 방향이 60초 그대로였다. 시뮬레이션에서 로봇과 토트 벽의 충돌을 꺼 둔 탓에 팔이 벽을 지나 토트 속 박스에 걸려 로봇이 붙들린 것이다. 시간 제한을 늘리는 것으로는 풀리지 않았고, 손을 빼는 동작을 넣자 두 배치 합이 206에서 240으로 올랐다.
AMR이 로봇을 통과하고 있었다(29~30차)
충돌 판정과 소품collision filtering, kinematic prop
물리 시뮬레이터는 충돌 비트가 맞는 물체끼리만 부딪힘을 계산한다. 정해진 경로로만 움직이는 물체는 힘을 받아도 밀리지 않아서, 충돌을 끄면 다른 물체를 그대로 지나간다.
AMR_CLEAR)을 넣어 완수 지시 12장을 다시 돌리니, 시뮬 시간의 약 절반 동안 겹쳤고 가장 깊은 곳은 22.6 cm였다.고친 것: 차체·토트 벽 충돌을 켬, 앞에 로봇이 있으면 서는 안전 정지와 닿으면 서는 범퍼(값은 가정값), 반대쪽 줄로 갈 때 로봇 앞에서 차선 바꾸기, AMR이 선 뒤 로봇이 걷기, 놓은 뒤 손을 토트 위로 뺀 다음 내리기. 200장 두 배치에서 가장 깊은 겹침은 3.1 cm이고, 이는 부드러운 접촉 모델에서 생기는 눌림이다.
판끼리 흔들림
같은 설정을 배치만 바꿔 다시 돌리면 지시 완수가 39장과 32장으로 달라졌다. 박스 하나를 놓친 차이가 뒤 칸의 경로를 모두 바꾸기 때문이다. 처음에는 200장 한 판의 흔들림을 약 ±5장으로 봤는데, 18차 설정을 배치만 바꿔 다시 돌리니 73장과 60장으로 13장이나 달랐다. 두 판씩 합치면 6차 설정 71/400(18 %), 18차 설정 133/400(33 %)이다. 막대 몇 장 차이는 개선으로 보지 않고, 큰 처치는 두 판으로 확인한다. 실패한 지시만 골라 고친 처치(일반 집기를 1 cm 낮게)는 그 묶음에서는 좋아 보였지만 전체 200장에서는 39장에서 28장으로 나빠져 되돌렸다. 처치는 전체 200장으로만 판단한다.
못 끝낸 이유
30차 두 배치에서 못 끝낸 정상 지시 97장: 집기·옮기기 실패 56, 박스 못 봄 12, 해석에서 멈춤 8, 담은 뒤 토트에서 빠짐 등 8, 큰 상자 6, 넘어짐 6, 도킹 1. 참고로 충돌을 켜기 전인 28차는 40장이었다.
예전 6차에서 못 끝낸 정상 지시의 첫 원인: 검수 25, 라벨이 앞을 보는 박스 집기 16, 못 봄 13, 넘어짐 3. 라벨 앞 박스 집기 실패는 토트 위로 옮기다 손에서 빠짐(15개)과 손이 박스까지 못 닿음(9개)으로 나뉜다. 못 본 박스 대부분은 앞 박스가 실패해 떨어진 박스 때문에 다음 칸 앞 20 cm 안에 서지 못한 경우다.
걷다가 막히는 판(15차)
14차에서 다음 박스를 못 본 지시 19건은 거의 모두 다음 칸까지 30초 안에 가지 못한 경우였다. 한 건을 0.5초마다 기록해 보니 두 가지였다. 통로 끝에서 반대쪽 칸으로 가려고 제자리에서 180° 도는 동안 옆으로 0.8 m 밀려, 돌고 나서 랙 끝 기둥 쪽으로 걸어가 막혔다. 칸을 비스듬히 본 채 통로 가운데로 물러나려 할 때는 뒤·옆 명령이 통로 방향으로 새어 3 m를 미끄러져 갔다. 돌 때는 돌기 시작한 점을 지키고, 물러나기는 5초를 넘기지 않게 했다. 못 본 박스가 35개에서 16개로, 지시 완수가 54에서 58로 늘었다. 그래도 몸이 랙 끝이나 AMR 토트에 걸려 제자리걸음하는 판이 남아, 3초 동안 5 cm도 못 가면 1초 물러났다 경로를 다시 잡고 걷기 제한을 45초로 늘렸다(16차: 못 본 박스 11, 지시 완수 61).
좁은 박스는 손목만 천천히(18차)
라벨 앞 박스 집기 실패는 폭 4.5 cm 박스(분할핀·퓨즈)에 몰렸다. 손가락을 더 세게 쥐게 하면 박스가 손가락에 밀려 오히려 들리지 않았고, 손과 손목을 함께 천천히 옮기거나(39 → 25) 손목을 아예 안 돌리면(61 → 17) 전체가 크게 나빠졌다. 옮기는 동안 0.1초마다 손과 박스 거리를 기록하니, 박스는 손에 잘 들려 있다가 토트 위로 가며 손목이 약 90° 도는 순간 빠졌다. 좁은 박스만 손목 도는 속도를 1.5에서 0.5 rad/s로 낮추고 손 속도는 그대로 두었다. 지시 완수가 61에서 73으로 늘었다.
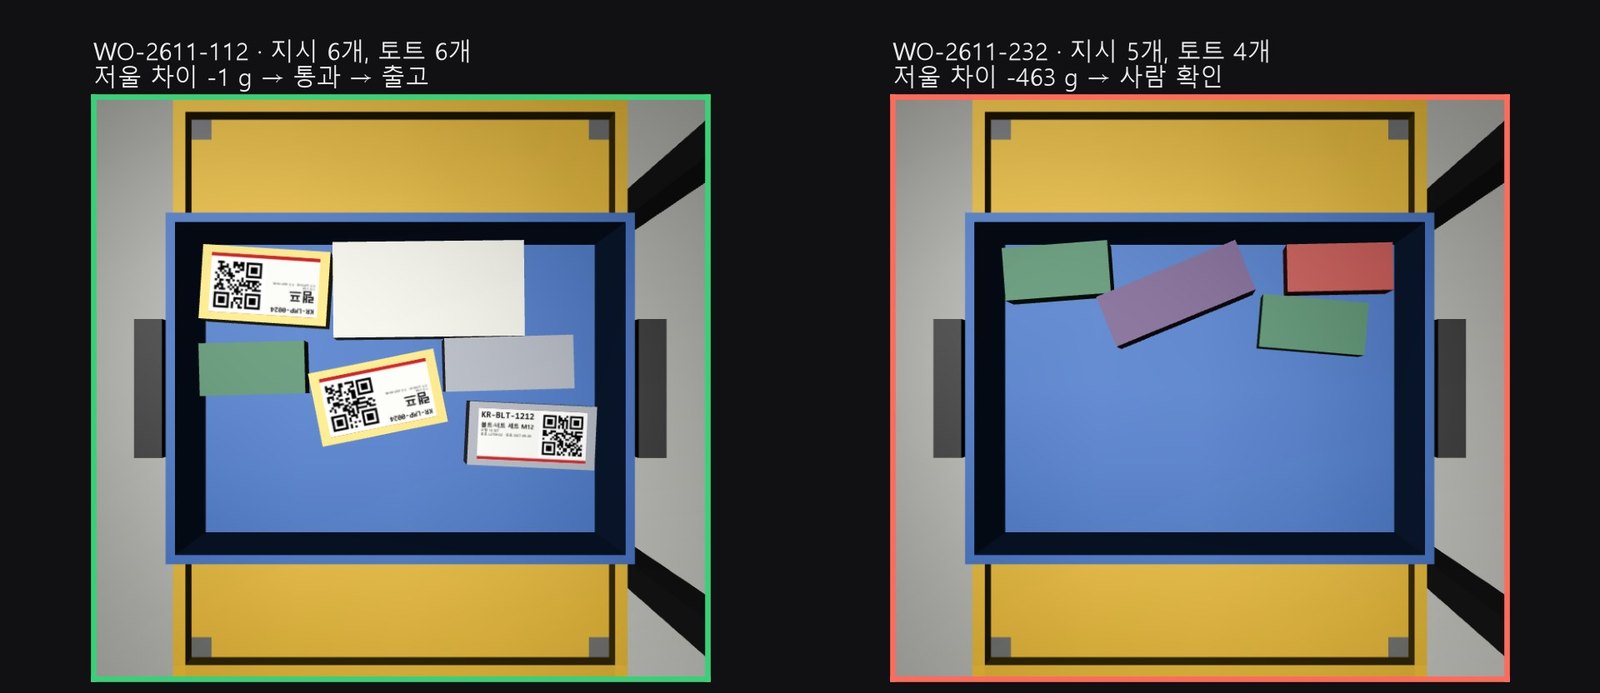
토트 출고와 출고 확인
처음 계획은 로봇이 토트를 두 손으로 들고 출고대까지 걷는 것이었다. 실제 피킹 창고처럼 AMR이 토트를 싣고 가는 쪽으로 바꿨다. 다 모으면 로봇이 AMR 차선 반대쪽으로 물러서고, AMR이 출고대 옆 도킹 자리로 간다. 로봇이 칸 앞에 선 채로 AMR을 보내면 AMR이 로봇 앞에서 차선을 바꾸며 로봇을 최대 1.9 m 밀고 갔다. 물러선 뒤에도 손이나 몸이 토트 속 박스에 걸려 끌려오면 10 cm에서 AMR이 멈추고 사람을 부른다(200장 중 3건 안팎). 옮기는 동안 토트에서 빠진 박스는 13·14차에서 1개씩, 15·16·18차에서 0개였다.
출고 확인outbound check
토트를 내보내기 전에 지시와 같은 물건이 들었는지 한 번 더 보는 일.
13월드모델로 환경 바꾸기
28차 기록의 두 장면(칸에서 집기, 큰 상자 두 손으로 들기)을 월드모델 Cosmos Transfer 2.5에 넣어 작업 환경만 철도 차량기지 부품창고(낮·야간)로 바꿨다. 네 편 모두 프레임 10·50·90에서 로봇 자세와 랙 위치가 원본과 맞았다.
제어 입력을 주는 영상 생성controlled video-to-video generation
원본 영상과 함께 깊이, 물체 종류별 색 구분, 물체 윤곽 같은 제어 영상을 주면, 월드모델이 구조는 제어를 따르고 재질·조명·배경은 글 프롬프트를 따라 새로 그린다.
tools/make_cosmos_pack.py). 설정은 공식 예제 값(깊이 0.6, 윤곽 1.0, 구분 0.4, guidance 3). DGX Spark 한 대에서 한 편에 약 45분.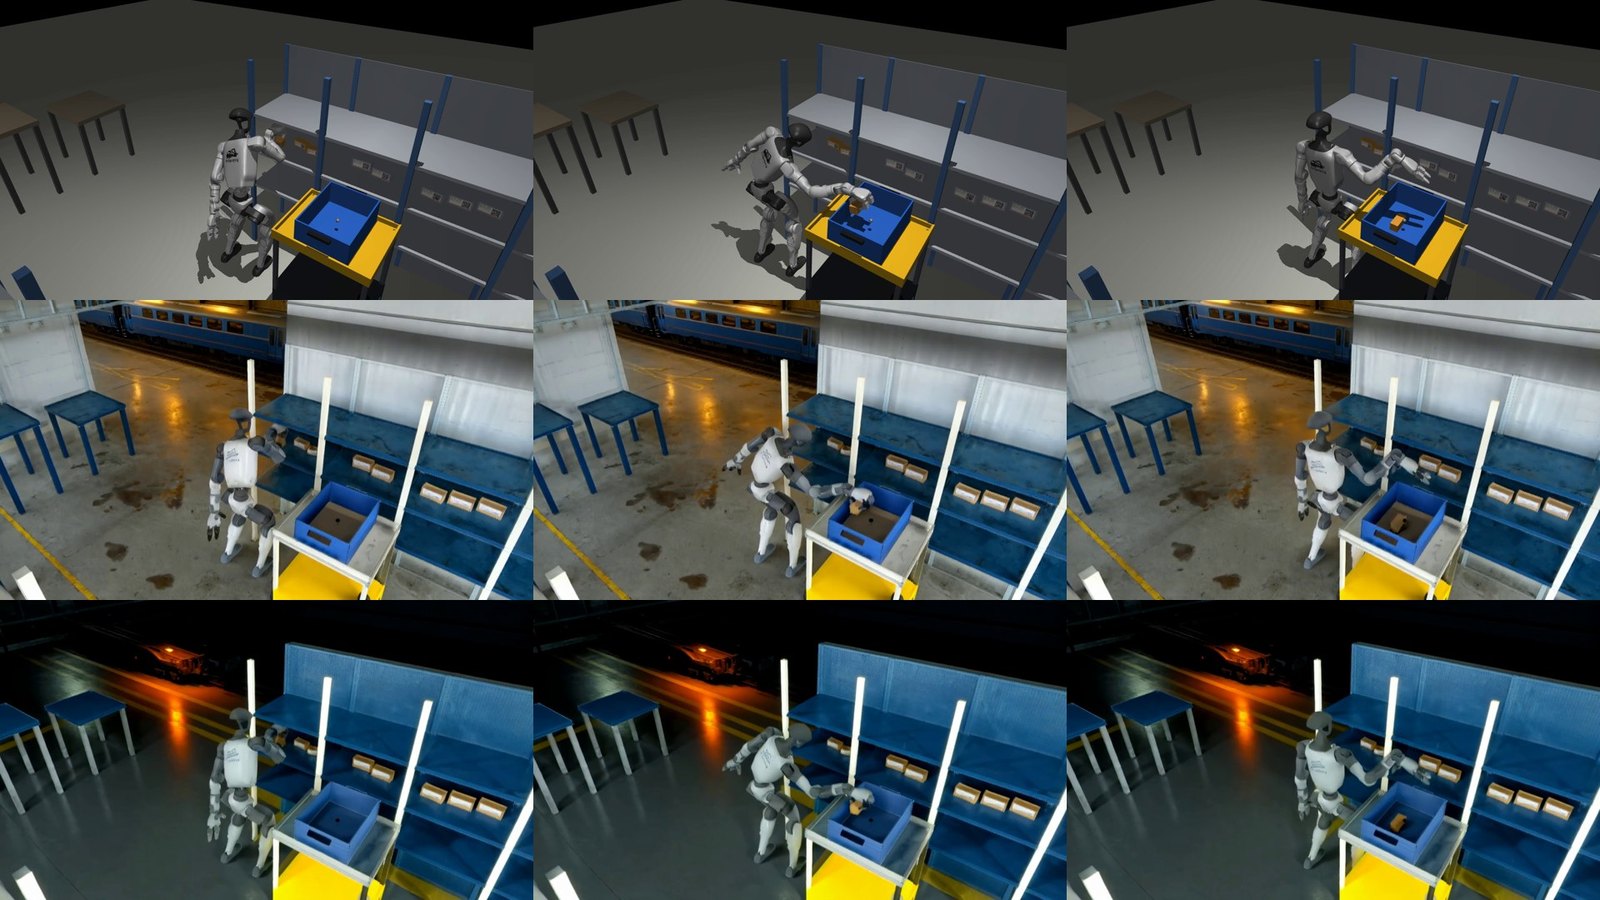
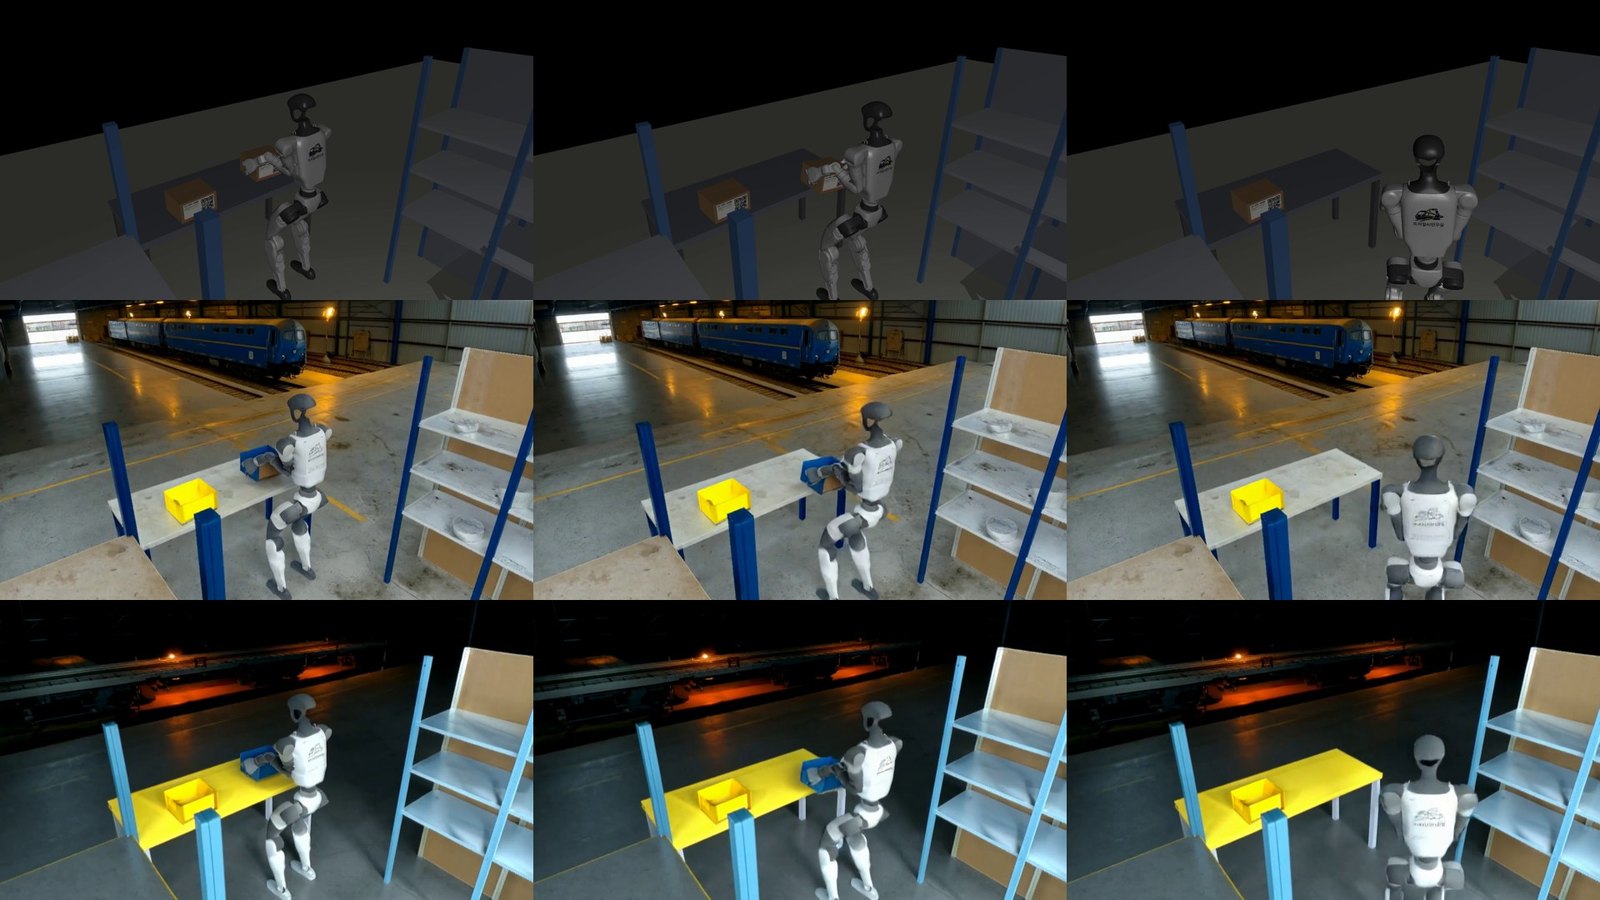
실사 렌더와 월드모델 증강의 차이
실사 렌더physically based rendering
물체 모양과 위치는 그대로 두고, 재질·빛을 물리 규칙으로 계산해 사진처럼 그리는 것.
만들다 생긴 버그 하나: 같은 종류 박스 셋이 라벨 판 모양 하나를 같이 쓰는데, 박스마다 재질 칸을 지우고 다시 만들어 앞 박스의 라벨 그림이 빠져 흰 판으로 나왔다. 재질 칸은 모양을 처음 불러올 때 한 번만 만든다.
14계산을 나눠 맡기
컴퓨터 네 종류에 일을 나눴다. 한 GPU에는 한 작업만 올리고, 원격 컴퓨터는 이 프로젝트 폴더만 쓴다.
| 계산 에이전트 | 하드웨어 | 맡은 일 |
|---|---|---|
| 에이전트 1 | RTX 5090 32 GB, CPU 16코어 | MuJoCo 시뮬레이션, 끝에서 끝 평가(12개 동시), 영상 렌더, 도면·그래프 |
| 에이전트 2 | A6000 48 GB × 2 | 작업지시서 해석·품명 확인 Qwen3.5-9B(GPU 0, 지시서 하나에 약 12초), 보행 학습 시도(GPU 1) |
| 에이전트 3·4 | DGX Spark × 2(GB10) | Cosmos Transfer 2.5 월드모델 증강(한 대에 한 편씩) |
| 에이전트 5 | RTX 3090, CPU 48코어 | 남는 CPU로 대량 평가(다른 연구가 바쁘면 쓰지 않음, 이번에는 쓰지 않음) |
15한계
모두 시뮬레이션이다. 25차부터 모든 박스의 라벨이 통로 쪽을 본다고 가정하므로, 적치가 잘못된 라벨(벽 쪽)은 다루지 않는다. 품번 체계, 박스 치수·무게, 깊이 카메라 결함 값은 가정값이고 실제 차량기지 자료로 확인하지 않았다. 작업지시서는 가상으로 만든 글이라 실제 지시서의 표기 다양성을 다 담지 못한다. 피킹 AMR은 정해진 경로로 움직이고 앞에 로봇이 있으면 서기만 해서, 실제 AMR처럼 길을 새로 찾지는 않는다(안전 정지 거리는 가정값). 토트는 로봇이 들고 가지 않고 AMR이 출고대 옆으로 싣고 간다(실제 피킹 창고에서 흔한 방식). 로봇이 토트를 두 손으로 드는 동작은 만들지 않았다.
16용어
모두 59개.
| 표제어 | 영문 | 한국어 | 설명 | 이 프로젝트에서 |
|---|---|---|---|---|
| active stereo | active stereo | 능동 스테레오 | 패턴을 비추고 두 카메라 시차로 거리 계산 | D435 방식 |
| AMR | Autonomous Mobile Robot | 자율주행 이동로봇 | 정해진 차선과 지점 사이를 스스로 다니는 바퀴 로봇 | 피킹 AMR이 토트를 싣고 로봇이 선 칸 옆으로 와서 기다림 |
| bumper | bumper | 범퍼 | 닿으면 서게 하는 감지 | AMR, 로봇과 닿으면 정지 |
| contype | contact type bits | 충돌 비트 | 어떤 물체끼리 부딪힐지 정하는 숫자 | 비트 4가 로봇-AMR·토트 벽 |
| Cosmos Transfer | NVIDIA Cosmos Transfer 2.5 | 제어 입력 영상 변환 월드모델 | 원본 영상과 깊이·구분·윤곽 제어를 받아 환경만 바꾼 영상을 만드는 모델 | 철도 차량기지 낮·야간 환경 네 편, DGX Spark에서 한 편 약 45분 |
| D435 | Intel RealSense D435 | 능동 스테레오 깊이 카메라 | 적외선 패턴과 두 카메라로 깊이를 재는 카메라 | G1 머리에 고정. 결함 네 가지를 시뮬레이션 깊이에 넣음 |
| Dex3 | Unitree Dex3-1 | 3지 손 | 손가락 세 개의 G1용 손 | 위에서 박스 좁은 쪽 두 면을 쥠(폭 약 6.2 cm까지) |
| DLS | Damped Least Squares | 감쇠 최소제곱 | 특이 자세에서 관절이 튀지 않게 값을 더해 푸는 IK | 허리 3 + 팔 7관절 풀이 |
| docking | docking | 도킹 | 정해진 자리에 맞춰 서기 | 출고대 옆, 첫 배치 133/134 |
| DoF | Degrees of Freedom | 자유도 | 로봇이 독립적으로 움직일 수 있는 방향의 수 | G1 + Dex3 모터 43개(02절) |
| domain randomization | domain randomization | 도메인 무작위화 | 시뮬 값을 흔들어 실제 차이에 대비 | 공개 정책의 학습 방법. 우리는 깊이 결함을 넣음 |
| e2e | end-to-end | 끝에서 끝 | 입력부터 최종 결과까지 사람 개입 없이 한 번에 돌리는 평가 | 지시서 글 → 언어모델 → 규칙 검사 → 로봇 출고, 200장 |
| FEFO | First Expired First Out | 먼저 만료 먼저 출고 | 유효기간이 먼저 끝나는 로트부터 내보내는 규칙 | 재고표와 머리 카메라 QR로 먼저 만료 박스를 고름 |
| FK | Forward Kinematics | 순기구학 | 관절 각도에서 손 위치를 계산 | IK 안에서 손 오차를 잴 때 씀 |
| friction cone | friction cone | 마찰 원뿔 | 옆 힘이 μN 안이면 안 미끄러짐 | 박스가 손에서 빠지는 이유(04절) |
| G1 | Unitree G1 | 휴머노이드 | 키 약 1.3 m의 연구용 휴머노이드 | 손 포함 모델, 관절 모터 43개 |
| GEAR-SONIC | GEAR-SONIC | 기어 소닉 | NVIDIA의 G1 전신 추적 정책 | 큰 상자에 다가갈 때만 |
| GR00T | NVIDIA GR00T | 휴머노이드 기반 모델·제어 | NVIDIA의 휴머노이드 기반 모델과 전신 제어 공개물 | 하체 보행 정책(서기·걷기)을 그대로 씀 |
| guardrail | guardrail | 막는 문 | 모델 출력을 코드로 거르는 장치 | 규칙 검사, 저울 |
| hallucination | hallucination | 환각 | 없는 사실을 있는 것처럼 답함 | 없는 부품에 품번을 채움 |
| held-out | held-out test set | 처음 쓰는 시험 세트 | 개발에 쓰지 않은 시험 자료 | 가상 지시서 200장 |
| HERO | Humanoid End-effector contROl (논문 이름) | 휴머노이드 손끝 추종 전신 제어 | UIUC가 공개한 G1 + Dex3 손 전신 제어 강화학습 정책. 손바닥 목표와 몸 기준 자세를 주면 29관절을 냄(CoRL 2026, MIT) | 라벨 앞 박스를 쥘 때까지 다리만 씀. 팔·허리까지 맡기면 오히려 실패 |
| IK | Inverse Kinematics | 역기구학 | 손을 둘 위치에서 관절 각도를 거꾸로 계산하는 방법 | 허리·팔을 역기구학으로, 다리는 보행 정책으로 |
| Jacobian | Jacobian matrix | 야코비안 | 관절 변화와 손 변화의 관계를 담은 행렬 | sim/kin.py의 IK 반복 |
| JSON | JavaScript Object Notation | 제이슨 | 항목과 값을 적는 글 형식 | 언어모델 출력 형식 |
| kp | proportional gain | 비례 이득 | 목표 차이에 곱하는 값. 크면 뻣뻣함 | 우리 팔 500, HERO 전제 14 |
| LLM | Large Language Model | 대형 언어모델 | 글을 읽고 쓰는 신경망 | Qwen2.5-VL 7B가 지시서를 피킹 목록(JSON)으로 |
| mocap | motion capture body | 위치 지정 물체 | MuJoCo에서 위치를 매 순간 옮겨 놓는 물체. 속도가 없어 마찰로 다른 물체를 끌지 못함 | 처음 회전판이 이것이라 박스가 안 돌았음 |
| MuJoCo | Multi-Joint dynamics with Contact | 물리 시뮬레이터 | 접촉이 있는 로봇 물리를 계산하는 시뮬레이터 | 모든 시험이 MuJoCo 3.17 |
| near plane | near clipping plane | 근접 절단면 | 이보다 가까운 것은 안 그림 | 0.31 m 버그(09절) |
| ONNX | Open Neural Network Exchange | 오닉스 | 학습된 신경망을 저장하는 공통 형식 | GR00T 하체 정책 파일 형식 |
| PBR | Physically Based Rendering | 물리 기반 렌더링 | 재질과 빛을 물리 규칙으로 계산해 그림 | 블렌더 Cycles |
| PD 제어 | Proportional-Derivative control | 비례-미분 제어 | 목표와의 차이와 속도로 힘을 정함 | G1 관절 모터 전체 |
| picking | order picking | 피킹 | 주문대로 물건을 꺼내 모으기 | 정비부품 출고 |
| pinhole | pinhole camera model | 핀홀 카메라 모델 | 화소와 3차원 방향을 잇는 카메라 모델 | 깊이 → 세계 좌표 |
| policy | policy | 정책 | 상태를 받아 행동을 내는 신경망 | GR00T, HERO, GEAR-SONIC |
| PPO | Proximal Policy Optimization | 근위 정책 최적화 | 정책 변화 폭을 제한해 학습하는 강화학습 | Stable-Baselines3 PPO로 시도 |
| QR | Quick Response code | 2차원 바코드 | 카메라로 읽는 사각 바코드 | 라벨에 품번/로트. 머리 카메라로 읽어 박스를 고름 |
| Qwen3.5 | Qwen3.5-9B | 큐웬 3.5 | Alibaba가 2026년 2월 공개한 언어·영상 모델(Apache-2.0) | 작업지시서 해석과 품명 확인. A6000 PC에서 지시서 하나에 약 12초 |
| residual RL | residual reinforcement learning | 잔차 강화학습 | 규칙 동작에 더할 수정만 학습 | 21/32 → 17/32로 나빠져 뺌 |
| RL | Reinforcement Learning | 강화학습 | 보상을 키우는 쪽으로 정책을 학습 | 보행·잔차 학습 시도, 최종판 미사용 |
| RMS | Root Mean Square | 제곱평균제곱근 | 오차 크기를 나타내는 값 | 깊이 잡음 0.6 m에서 약 1.3 mm |
| safety stop | protective stop | 안전 정지 | 앞에 물체가 있으면 서는 동작 | AMR, 값은 가정값 |
| selection bias | selection bias | 선택 편향 | 고른 자료로 재서 값이 치우침 | 실패 묶음에서 좋아 보인 처치 |
| sim-to-real | simulation to reality | 시뮬-실제 전이 | 시뮬 결과를 실제 로봇으로 옮기는 일 | 이번에는 하지 않음 |
| slip | slip | 미끄러짐 | 쥔 물체가 손 안에서 움직임 | 못 끝낸 지시의 첫째 원인 |
| soft contact | soft contact model | 부드러운 접촉 | 조금 파고드는 것을 허용하는 접촉 계산 | 로봇-AMR 겹침 최대 3.1 cm |
| standard error | standard error | 표준오차 | 표본 비율이 흔들리는 크기 | 89/200에서 약 3.5 %포인트 |
| timestep | simulation timestep | 시뮬레이션 간격 | 물리를 한 번 계산하는 시간 폭 | 0.002 s |
| weld | weld equality constraint | 용접 구속 | 두 물체를 상대 자세 그대로 붙이는 구속 | 토트를 AMR에 붙임 |
| WMS | Warehouse Management System | 창고 관리 시스템 | 어느 칸에 무슨 재고가 있는지 기록하는 시스템 | 가상 재고표(박스 33개, 종류마다 로트 3개) |
| work order | work order | 작업지시서 | 정비에 쓸 부품을 적은 지시 문서 | 가상 지시서 200장 |
| world model | world foundation model | 월드모델 | 세계의 영상을 생성·예측하는 모델 | Cosmos Transfer 2.5 |
| znear | near clipping plane | 근접 절단면 | 카메라 바로 앞 이 거리 안은 그리지 않음 | 장면 크기 비례로 0.31 m라 손이 잘려 보였음 → 2 cm |
| zxing-cpp | ZXing C++ port | QR 읽기 라이브러리 | 바코드·QR을 읽는 오픈소스(Apache-2.0) | 머리 카메라 화면에서 박스 라벨 QR(품번/로트)을 읽음 |
| 검수대 | inspection turntable | 회전 검수대 | 박스를 올려 돌려 라벨을 보이게 하는 판 | 윗판이 관절과 모터로 180° 돔(가정값) |
| 규칙 검사 | rule-based verification | 규칙 검사 | 언어모델 출력을 원문·카탈로그·재고와 대조해 이상하면 멈추는 단계 | 틀린 목록 실행 83장 → 2장 |
| 토트 | tote | 부품 바구니 | 부품을 담아 나르는 플라스틱 상자 | 40 × 30 × 15 cm, AMR 위 |
| 품명 확인 | name verification | 품명 확인 | 규칙의 글자 대조가 못 맞춘 줄만 언어모델에게 같은 부품인지 다시 묻는 단계 | '코터핀 4mm' ↔ '분할핀 세트 φ4' 같은 줄. 대조 55개에서 잘못 '같음' 0 |
17참고 자료
- Todorov 외 2012. MuJoCo: A physics engine for model-based control. IROS. DOI
- Wampler 1986. Manipulator inverse kinematic solutions based on vector formulations and damped least-squares methods. IEEE Trans. SMC. DOI
- Schulman 외 2017. Proximal Policy Optimization Algorithms. arXiv 1707.06347
- Tobin 외 2017. Domain Randomization for Transferring Deep Neural Networks from Simulation to the Real World. arXiv 1703.06907
- Johannink 외 2019. Residual Reinforcement Learning for Robot Control. arXiv 1812.03201
- Mahler 외 2017. Dex-Net 2.0: Deep Learning to Plan Robust Grasps. arXiv 1703.09312
- Morrison 외 2018. Closing the Loop for Robotic Grasping (GG-CNN). arXiv 1804.05172
- NVIDIA 2025. GR00T N1: An Open Foundation Model for Generalist Humanoid Robots. arXiv 2503.14734
- Dai 외 2022. DREDS: Domain Randomization-Enhanced Depth Simulation. arXiv 2208.03792
- Intel. RealSense D400 Series Datasheet. PDF
- NVIDIA. Isaac Lab, Depth camera randomization. 문서
- NVIDIA. Cosmos Transfer 2.5. GitHub, Cosmos Cookbook 문서
- Unitree. G1 humanoid, Dex3-1 hand. unitree.com/g1
- MuJoCo Menagerie, unitree_g1. GitHub
- Qwen3.5-9B. Hugging Face, Qwen2.5-VL. Hugging Face
- Dong 외 2026. HERO: Learning Humanoid End-Effector Control for Visual Whole-Body Open-Vocabulary Object Grasping. arXiv 2602.16705, GitHub
- NVIDIA. GR00T-WholeBodyControl(Decoupled WBC 하체 정책, GEAR-SONIC). GitHub
- zxing-cpp. GitHub